Data integration là gì? Từ dữ liệu rời rạc đến report
Data integration là gì, giúp ích gì cho doanh nghiệp? Hiểu cách Undercroft kết nối nguồn, giữ raw data và những đánh đổi trước khi lựa chọn.
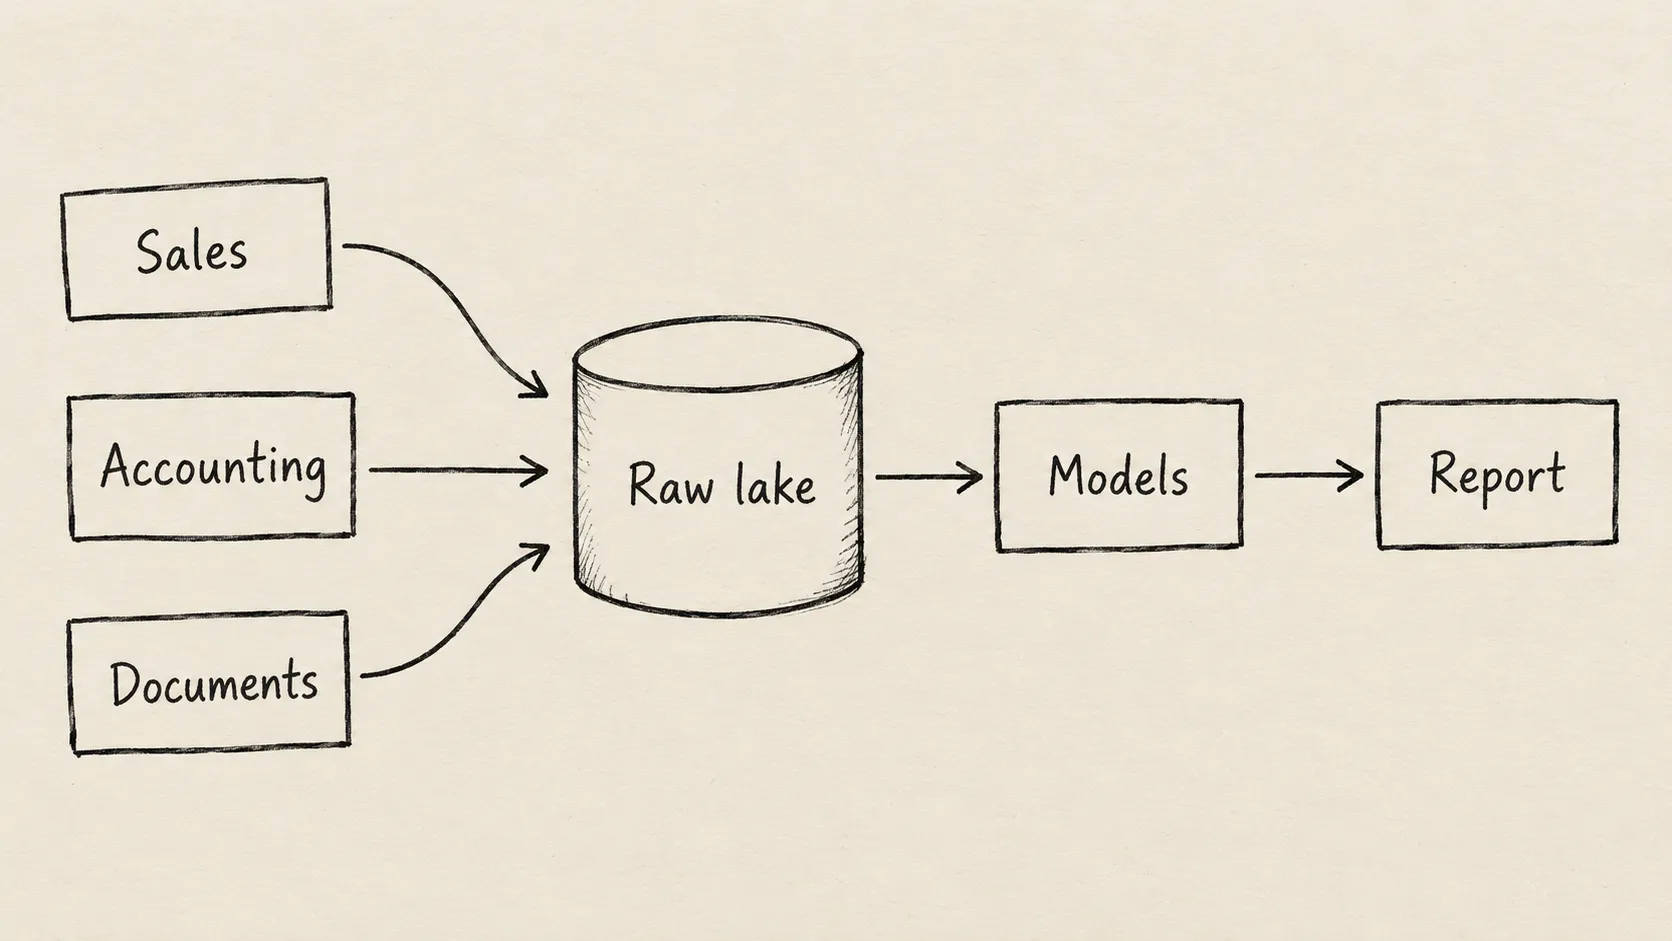
Data integration là gì mà doanh nghiệp cần quan tâm? Hãy nghĩ đến kỳ chốt báo cáo: kinh doanh theo dõi giao dịch trên HubSpot, kế toán giữ hóa đơn trong Xero, còn tài liệu nằm ở Gmail. Muốn biết giao dịch nào đã thu tiền, mọi người lại xuất dữ liệu rồi đối chiếu bằng tay. Công việc lặp lại, nhưng vẫn khó biết bản nào mới nhất.
Data integration giúp các nguồn đó được sử dụng cùng nhau. Giá trị không chỉ là bớt thao tác: người đọc report cần biết số liệu đến từ đâu, còn thiếu gì và được tính theo quy tắc nào.
Data integration là gì, khác data pipeline thế nào?
Có thể hình dung data integration như việc gom hồ sơ về cùng bàn làm việc. Hồ sơ đã ở cạnh nhau chưa có nghĩa là khớp nhau. Doanh nghiệp vẫn phải thống nhất khi nào ghi nhận một giao dịch: lúc chốt bán, xuất hóa đơn hay nhận tiền.
Data pipeline là chuỗi bước thu thập, lưu và xử lý dữ liệu. Connector phụ trách đọc từng nguồn; REST API là cách ứng dụng cho hệ thống khác lấy thông tin trong phạm vi được cấp quyền. Đây là phương tiện, còn mục tiêu là trả lời đúng câu hỏi kinh doanh.
Undercroft kết nối dữ liệu theo cách nào?
Undercroft lưu raw data vào data lake trước, rồi đưa dữ liệu thu thập được sang Postgres để phục vụ phân tích. Đội ngũ của bạn viết dbt model để áp dụng quy tắc nghiệp vụ và chuẩn bị dữ liệu cho report hoặc BI. Platform không quyết định sẵn khách hàng hay doanh thu phải được hiểu thế nào.
Raw data đã lưu không bị ghi đè. Nội dung giống nhau không cần lưu thêm bản nữa; nội dung thay đổi có thể được giữ thành phiên bản mới. Khi sửa cách tính report, đội kỹ thuật có thể xử lý lại từ raw data còn được giữ. Bài về raw data lake bất biến giải thích lợi ích này.
Xero và HubSpot dùng chung cơ chế connector: mô tả cách đọc từng nguồn, rồi dùng lại phần thu thập. Gmail và Google Drive có cách thu thập riêng cho email và tài liệu, nhưng cùng đưa nội dung vào data lake. Thêm nguồn mới vẫn cần công việc kỹ thuật và phát hành sản phẩm; không phải REST API nào cũng có thể kết nối ngay.
Nên hiểu ETL và ELT trong data integration ra sao?
ETL lấy dữ liệu, biến đổi rồi mới đưa kết quả vào nơi lưu trữ phục vụ phân tích. ELT đưa dữ liệu vào trước, sau đó mới biến đổi theo nhu cầu. Data integration là mục tiêu rộng hơn; ETL và ELT là cách tổ chức công việc.
Undercroft đi theo ELT, giữ raw data trước khi chạy model của người dùng. Cách này hữu ích khi câu hỏi kinh doanh thay đổi, nhưng doanh nghiệp phải có người chịu trách nhiệm về định nghĩa chỉ tiêu. Bài ETL và ELT khác nhau thế nào giúp cân nhắc lựa chọn đó.
Incremental sync có bảo đảm dữ liệu luôn mới không?
Incremental sync tập trung vào phần thay đổi từ lần đọc trước. Có thể coi đó là dấu đánh trang khi đọc một cuốn sổ dài. Undercroft chỉ dời dấu sau khi đọc xong danh sách liên quan; lần đọc bị gián đoạn không được coi là đã kiểm tra hết.
Hiệu quả còn tùy nguồn. Có REST API trả riêng phần thay đổi, nhưng có nguồn vẫn cần đọc toàn bộ danh sách rồi mới lọc. Vì vậy, incremental sync có thể giảm việc lưu và xử lý lại mà không giảm số lần yêu cầu dữ liệu.
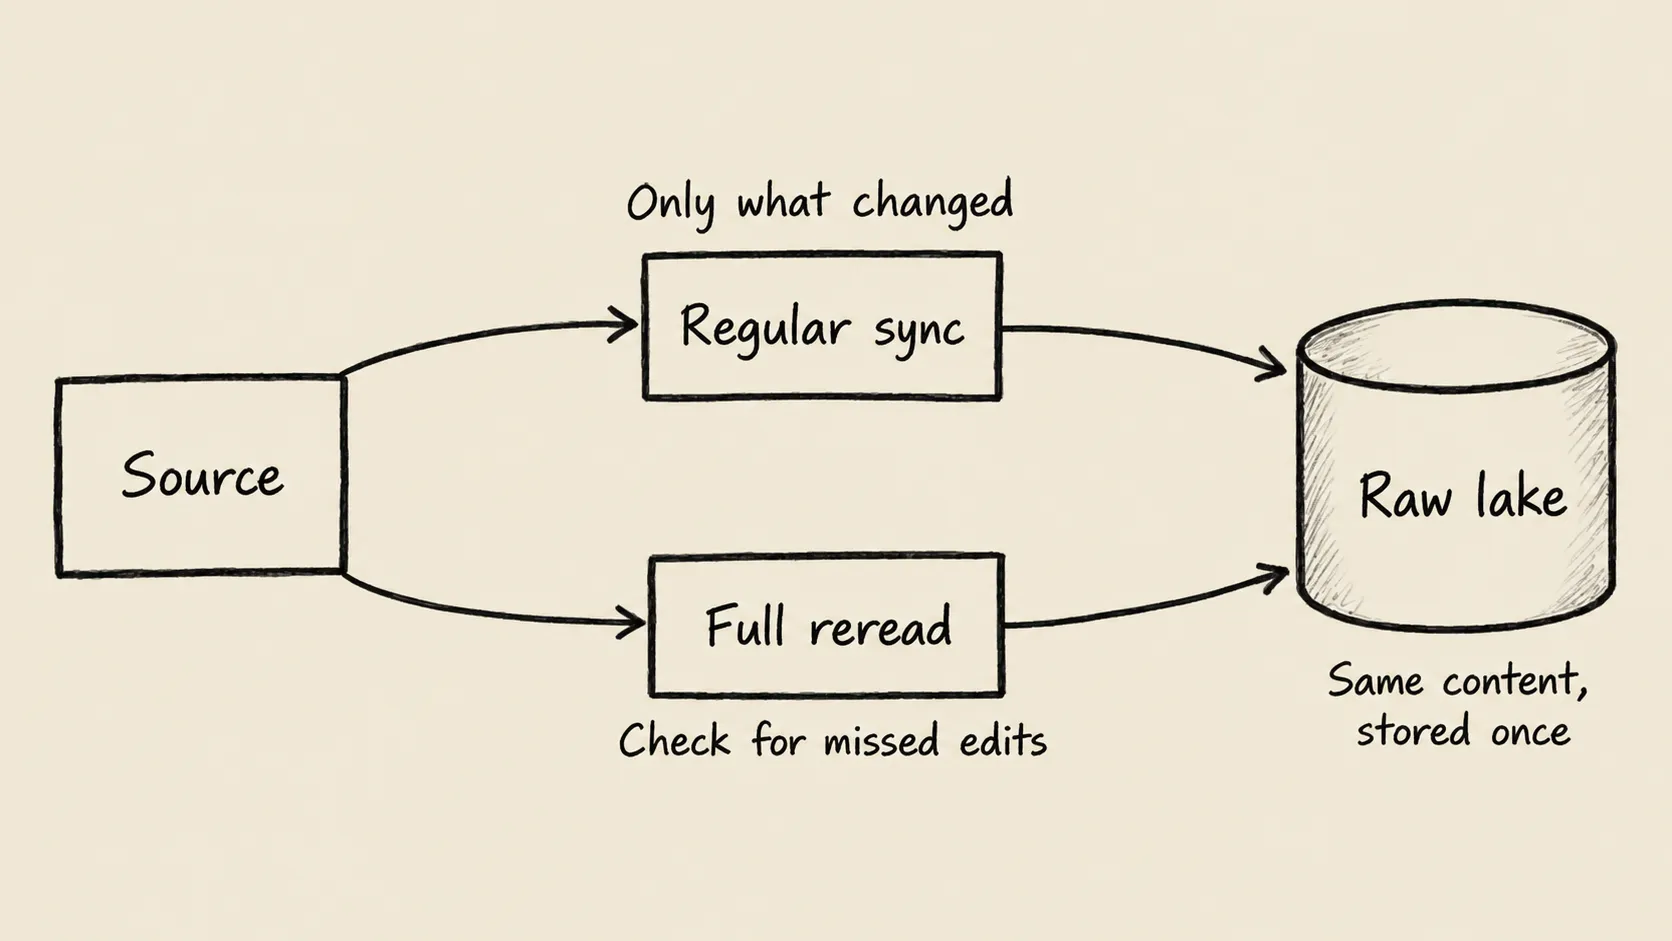
Nguồn cũng có thể không báo mọi chỉnh sửa. Với kết nối phù hợp, Undercroft cho phép bật lịch đọc toàn bộ để tìm thay đổi mà incremental sync có thể bỏ qua. Cần chủ động bật khi cần; việc này dùng thêm khả năng truy cập nguồn và không bảo đảm dữ liệu mới ngay lập tức.
Làm sao biết một lần sync đã lấy đủ dữ liệu?
Kết nối thành công chưa chứng minh dữ liệu đã đầy đủ. Một danh sách không có kết quả có thể do chưa phát sinh dữ liệu, chưa có thay đổi, hoặc tài khoản không được phép đọc. Những tình huống này mang ý nghĩa khác nhau với người làm báo cáo.
Undercroft điều tiết việc đọc, thử lại với một số lỗi tạm thời và báo lỗi connector thay vì biến lỗi thành kết quả rỗng. Nhật ký của lần chạy giúp người quản trị xem tiến độ và cảnh báo sau đó. Một lần chạy kết thúc vẫn có thể kèm cảnh báo thiếu quyền hoặc phải tạm dừng đọc vì giới hạn của nguồn.
Vì thế, cần xem cảnh báo cùng số lượng dữ liệu nhận được. Không nên diễn giải phần chưa đọc được thành “không có giao dịch”.
Khi nào cách tiếp cận này phù hợp với doanh nghiệp?
Undercroft phù hợp với đội ngũ muốn kiểm soát raw data và tự xây dựng quy tắc cho report. Việc giữ dữ liệu nguồn có ích khi cần giải thích số liệu cũ hoặc tính lại theo định nghĩa mới.
Đổi lại, mô hình self-hosted cần người vận hành; model cần người hiểu nghiệp vụ và dữ liệu. Doanh nghiệp cũng phải quyết định cách lưu giữ và kiểm soát truy cập. Undercroft là open-source, đang ở giai đoạn pre-alpha và còn được xây dựng tích cực.
Nếu cần dịch vụ được vận hành sẵn, report nghiệp vụ dùng ngay hoặc cập nhật tức thời có bảo đảm, đây có thể chưa phải lựa chọn phù hợp. Tính linh hoạt đi kèm phần việc mà đội ngũ phải đảm nhận.
Nên bắt đầu tìm hiểu từ đâu?
Chọn một câu hỏi kinh doanh có thể đối chiếu kết quả, xác định nguồn cần đọc và độ trễ chấp nhận được. Bạn có thể khám phá Undercroft và xem repository của dự án để đánh giá sản phẩm cùng yêu cầu triển khai. Một đợt thử nhỏ nên làm rõ cả độ đầy đủ của dữ liệu lẫn cách model diễn giải nó.
Câu hỏi thường gặp
Data integration có phải là ETL không?
ETL là một cách tổ chức công việc trong data integration. Undercroft dùng ELT, giữ raw data trước rồi mới áp dụng quy tắc nghiệp vụ qua model.
Có thể kết nối mọi REST API với Undercroft không?
Connector chung chỉ hỗ trợ những cách đọc nằm trong khả năng của nó. Nguồn khác có thể cần xử lý riêng và công việc kỹ thuật để đưa vào sản phẩm.
Incremental sync có luôn giảm số lần gọi API không?
Không, một số nguồn vẫn phải được đọc hết để tìm thay đổi. Khi đó, lợi ích nằm ở việc giảm lưu trữ và xử lý lặp lại.
Data integration có cung cấp report theo thời gian thực không?
Điều đó phụ thuộc lịch thu thập, khả năng của nguồn và bước xử lý tiếp theo. Undercroft dùng sync theo lịch, nên cần đánh giá độ trễ theo nhu cầu ra quyết định.